大笠科技AI大底座 构建大模型研发基础设施的系统化方案
大笠科技AI大底座:构建大模型研发基础设施的系统化方案
一、背景与挑战
随着大语言模型和生成式AI技术的快速演进,企业对大模型研发的需求已从“能否训练”转向“能否高效、稳定、可持续地训练和运行”。大模型研发面临算力成本高、异构资源调度复杂、数据治理难度大、训练稳定性不足、工程化门槛高等系统性挑战。单个团队往往在基础设施环节投入大量精力,却难以形成可复用的能力沉淀。
大笠科技推出的“AI大底座”方案,正是面向这一痛点设计的大模型研发基础设施体系,旨在为企业提供从算力资源管理、数据治理、训练框架到模型评测与部署的全链路支撑。
二、方案总体架构
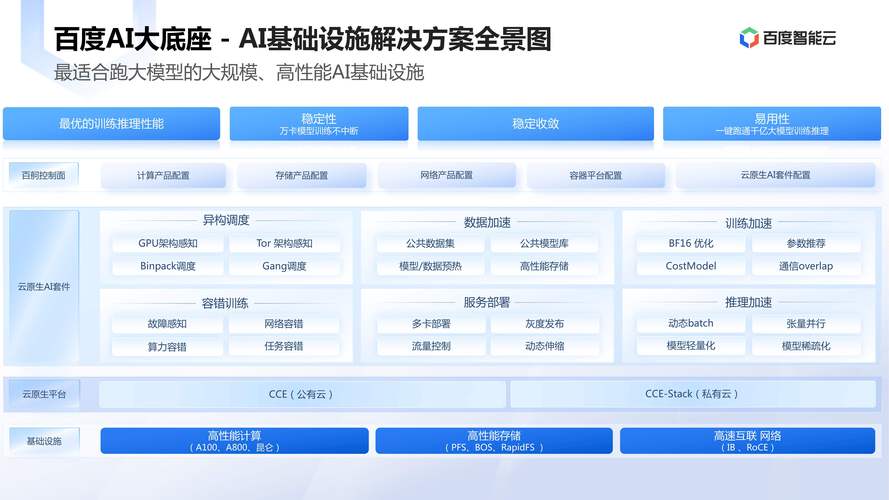
大笠科技AI大底座采用分层解耦、模块化设计的思路,整体分为四层:
1. 算力资源层
涵盖GPU集群、高性能网络(如RDMA)、分布式存储和容器化调度平台的统一管理。通过异构资源抽象与池化技术,实现GPU、CPU、存储资源的统一纳管和弹性分配,支持多租户隔离和优先级调度,提升集群利用率。
2. 训练引擎层
提供分布式训练框架适配能力,支持数据并行、张量并行、流水线并行及混合并行策略,兼容主流深度学习框架。内置通信优化、显存优化和容错恢复机制,降低大规模训练中的中断风险。
3. 数据与模型资产层
构建统一的数据治理管线,覆盖数据采集、清洗、标注、版本管理和质量评估;同时提供模型仓库、实验追踪和版本管理能力,确保数据与模型资产可追溯、可复用。
4. 平台服务层
面向研发团队提供可视化作业管理、实验管理、模型评测、推理服务和监控告警等能力,降低工程化使用门槛,支撑从实验到生产的完整闭环。
三、核心能力设计
弹性算力调度:基于容器编排与配额管理,支持训练任务的排队、抢占与弹性伸缩,结合资源监控实现算力使用的精细化管理。
高效分布式训练:针对通信瓶颈提供拓扑感知调度和梯度压缩优化,结合Checkpoint快速保存与恢复机制,保障长周期训练的稳定性。
全链路数据治理:建立数据血缘与版本管理机制,支持多源数据接入和隐私合规处理,为大模型训练提供高质量、可审计的数据基础。
模型全生命周期管理:覆盖实验记录、指标对比、模型评测、灰度发布与在线推理,形成研发到上线的可复用流水线。
可观测性与运维保障:提供集群、任务、网络、存储多维监控,结合告警与日志分析,帮助运维团队快速定位问题。
四、典型应用场景
该方案适用于多种大模型研发场景:企业内部大模型预训练与微调、行业垂域模型构建、AI研发平台私有化部署、多团队共享算力平台建设等。通过统一底座,企业可减少重复建设,将研发力量集中于模型效果与业务价值。
五、实施路径建议
大笠科技建议采用分阶段落地策略:第一阶段完成算力池化与调度平台建设,夯实资源基础;第二阶段引入数据治理与训练引擎优化,提升研发效率;第三阶段完善模型评测、部署与运维体系,实现全链路闭环。方案支持私有化部署与混合云模式,兼顾数据安全与弹性需求。
六、
AI大底座的本质,是将大模型研发中的基础设施能力产品化、平台化。大笠科技通过系统化的架构设计与工程实践,帮助企业降低大模型研发的工程门槛,提升资源利用效率和研发迭代速度,为AI能力的规模化落地提供坚实支撑。随着模型规模和场景复杂度的持续提升,大底座方案也将持续演进,成为企业AI竞争力的重要基础设施。
如若转载,请注明出处:http://www.dalibaoxian.com/product/8.html
更新时间:2026-11-01 08:43:22